Per prevedere la domanda nella moda, imposta una baseline statistica e aggiungi un layer di demand sensing operativo. La combinazione riduce l’errore sui SKU ad alta rotazione e limita l’invenduto, ma funziona solo con una governance dei dati chiara e un owner che gestisce le eccezioni giorno per giorno.
In breve:
- Per previsione dei SKU in moda, è fondamentale mantenere un monitoraggio settimanale di accuratezza, sell-through e tasso di stockout per agire tempestivamente.
- I metodi più adatti variano in base al lead time e alla quantità di storico disponibile, privilegiando modelli semplici o probabilistici per prodotti altamente imprevedibili.
- Il demand sensing migliora l’accuratezza a breve termine, richiedendo dati di vendita POS giornalieri e segnali di traffico in tempo reale.
- Un progetto pilota efficace deve partire su un numero ristretto di SKU ad alta rotazione, con un ciclo di circa sei-otto settimane, prima di espandersi.
- È imprescindibile affidarsi a sistemi di integrazione dati e ad una governance chiara, per evitare che dati sporchi compromettono previsioni avanzate.
Indice
- Perché la previsione della domanda moda è così rischiosa
- Metodologie di previsione: quale scegliere in base ad assortimento e lead time
- Demand sensing: cos’è, cosa richiede e cosa aspettarsi davvero
- Roadmap operativa: dal pilot alla scala
- Che infrastruttura dati serve per un forecasting avanzato
- Come GreenSharp supporta i progetti di previsione domanda nel fashion
- Dati, algoritmi e la parte che nessun modello prevede
- Avvia un progetto pilota di demand sensing con GreenSharp
- Fonti
- Domande frequenti
Perché la previsione della domanda moda è così rischiosa
La moda non si comporta come il largo consumo. I cicli di vita dei prodotti si sono compressi, i social amplificano o distruggono una collezione in pochi giorni, e le promozioni fuori calendario stravolgono qualsiasi curva stagionale calcolata a tavolino. Un modello che funziona benissimo su un capo basic va in crisi su un capo moda con tre settimane di vita commerciale utile.
Il rischio si traduce in numeri concreti su tre fronti:
- Invenduto e markdown: ogni punto di errore previsionale sui capi stagionali si trasforma quasi meccanicamente in sconto a fine stagione, con effetto diretto sul margine.
- Stockout sui best seller: sottostimare la domanda su un pezzo virale significa perdere vendite proprio quando il prodotto vende di più.
- Danno reputazionale: un negozio o un sito che esaurisce la taglia giusta nel momento sbagliato perde il cliente anche sulla collezione successiva.
I consumi di moda in Italia stanno mostrando segnali di ripresa contenuta per il biennio 2026-27, ma il prezzo e il Made in Italy restano i driver decisivi nelle scelte d’acquisto. Questo significa che un errore di previsione oggi pesa di più sul margine di quanto pesasse in una fase di crescita robusta, perché il cliente compra meno e sceglie con più attenzione dove spendere.
Per misurare davvero il rischio, tre metriche bastano per iniziare: la forecast accuracy per SKU o per cluster di prodotto, il sell-through nelle prime due settimane di vendita e lo stockout rate sui top seller. Se non tracci queste tre cifre ogni settimana, qualsiasi discorso su intelligenza artificiale o modelli avanzati è prematuro: prima serve un cruscotto che dica dove stai perdendo margine oggi.
Metodologie di previsione: quale scegliere in base ad assortimento e lead time
Non esiste un metodo unico valido per tutto l’assortimento. La scelta dipende da quanto tempo hai prima di dover ordinare, da quanti dati storici possiedi e da quanto è imprevedibile lo specifico prodotto.
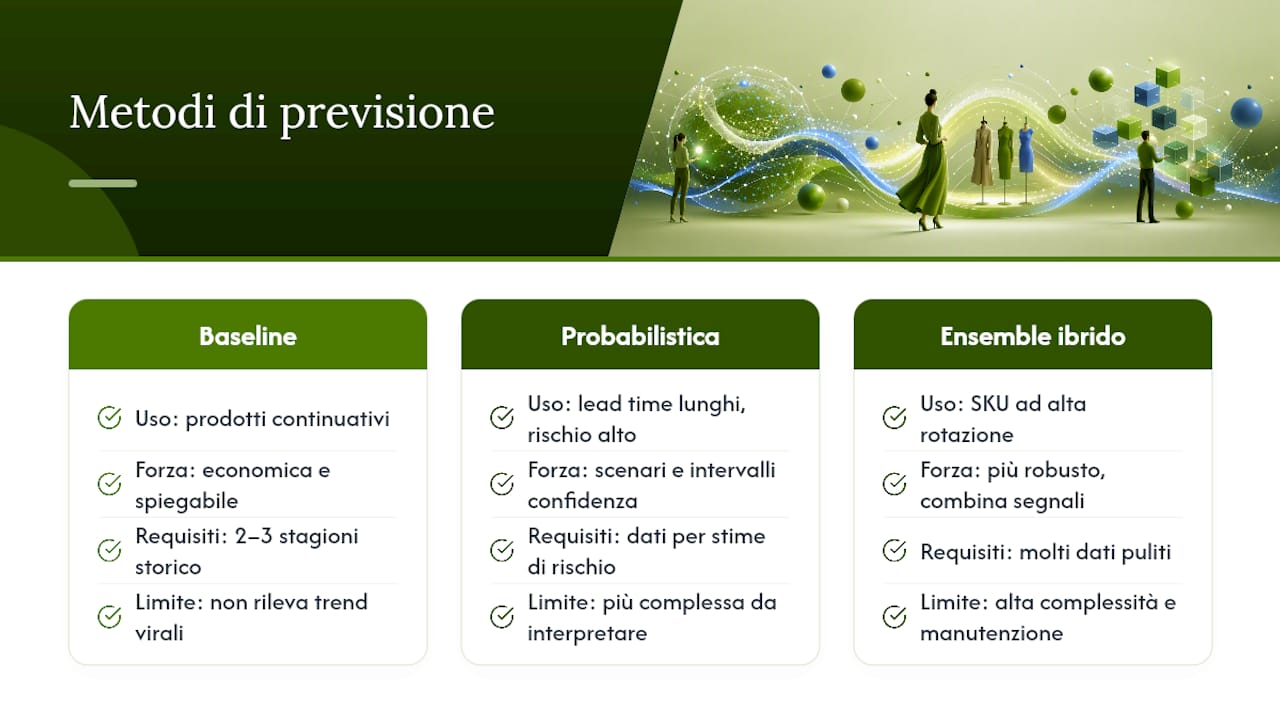
La baseline statistica resta il punto di partenza per la maggior parte dei brand. Modelli di time-series come medie mobili ponderate, smoothing esponenziale o ARIMA funzionano bene su prodotti continuativi, capi basic e categorie con storico pulito di almeno due o tre stagioni. Sono economici da mantenere, spiegabili a un planner senza background statistico e sufficienti quando il lead time di produzione è lungo e il margine di errore accettabile è ampio. Il limite è evidente: una baseline statistica non “vede” un trend virale che nasce in sette giorni.
La previsione probabilistica aggiunge quello che la baseline statistica non dà: una gamma di scenari invece di un numero secco. Anziché stimare “venderemo 4.000 pezzi”, un modello probabilistico restituisce un intervallo di confidenza, per esempio tra 3.200 e 5.100 pezzi con una probabilità associata a ciascuno scenario. Questo è particolarmente utile per decidere quanto stock di sicurezza tenere su una categoria volatile, o per calibrare l’open-to-buy quando il rischio di sbagliare in una direzione (invenduto) e nell’altra (stockout) hanno costi molto diversi.
Gli ensemble ibridi combinano più tecniche, spesso una componente statistica classica più un modello di machine learning che assorbe segnali esterni (meteo, ricerche online, comportamento sui social). Nella pratica, un ensemble ben costruito tende a essere più robusto di un singolo modello perché compensa gli errori sistematici di un metodo con i punti di forza di un altro. Lo svantaggio è la complessità: serve più dato pulito, più manutenzione e un team capace di interpretare risultati che non sono più un semplice numero da un foglio Excel.
Un consiglio: Non scegliere il metodo più sofisticato disponibile: scegli quello che il tuo team può interpretare e correggere ogni settimana. Un modello ibrido che nessuno sa leggere produce peggiori decisioni di una baseline statistica ben capita.
I criteri decisionali pratici sono tre. La velocità di vendita dello SKU: capi ad alta rotazione giustificano l’investimento in modelli più complessi, capi a bassa rotazione no. Il lead time di produzione: un lead time lungo (90-120 giorni) richiede previsione probabilistica per gestire l’incertezza sul lungo periodo, un lead time corto si presta meglio al demand sensing. La disponibilità di dati: senza almeno due o tre stagioni di storico strutturato per SKU, l’intelligenza artificiale applicata al forecasting wholesale restituisce risultati deludenti, indipendentemente da quanto avanzato sia l’algoritmo scelto.
Demand sensing: cos’è, cosa richiede e cosa aspettarsi davvero
Il demand sensing non sostituisce la previsione tradizionale: la corregge nel breve periodo. Le piattaforme di settore descrivono il sensing come un layer complementare che usa segnali live, come le vendite del giorno prima o il traffico su un prodotto specifico, per aggiornare in continuazione una stima che altrimenti resterebbe statica per settimane. La differenza pratica è questa: la baseline statistica ti dice quanto venderai in un trimestre, il sensing ti dice se stai vendendo più o meno di quanto previsto proprio questa settimana, e ti permette di reagire prima che sia troppo tardi per riassortire o spostare stock tra punti vendita.
Per funzionare, il demand sensing ha bisogno di alcuni feed di dati precisi:
- Vendite POS giornaliere, non settimanali o mensili: è il segnale più importante e il più spesso trascurato.
- Dati e-commerce in tempo reale, incluse aggiunte al carrello e ricerche interne al sito, che spesso anticipano il picco di vendita fisica.
- Calendario promozionale, perché una promozione non comunicata al modello genera un falso segnale di domanda organica.
- Dati meteo, soprattutto per categorie stagionali come outerwear o capi in maglia.
- Segnali social e di ricerca, utili per anticipare picchi virali su capi specifici prima che si traducano in vendite.
Quando questi feed sono in ordine, i risultati sono misurabili. Applicare demand sensing sopra una baseline statistica stabile porta tipicamente a un miglioramento dell’accuratezza tra il 10% e il 20% sui prodotti ad alta velocità, con i guadagni più marcati proprio sugli SKU sensibili a promozioni e picchi di domanda improvvisi.
I pilot falliscono quasi sempre per lo stesso motivo: dati POS incompleti o aggiornati con giorni di ritardo, oppure l’assenza di un owner che decida come gestire le eccezioni quando il modello e l’intuito del planner non sono d’accordo. Un sistema di sensing tecnicamente perfetto ma alimentato con dati sporchi produce previsioni sbagliate più velocemente di una semplice baseline statistica, perché reagisce anche al rumore.
Roadmap operativa: dal pilot alla scala
Partire in grande è l’errore più comune. Un perimetro pilota tra 200 e 500 SKU, concentrato su una o due categorie ad alta rotazione, permette di validare il metodo senza mettere a rischio l’intero assortimento e senza sovraccaricare il team con troppe eccezioni da gestire in parallelo.
Le fasi tipiche di un progetto seguono questa sequenza:
- Foundation: audit dei dati esistenti, pulizia dello storico per SKU, definizione degli identificatori unici prodotto e connessione dei feed POS ed e-commerce.
- Pilot in shadow mode: il nuovo modello genera previsioni in parallelo al processo esistente, senza sostituirlo, così puoi confrontare accuratezza reale prima di fidartene per le decisioni di riordino.
- Scale: estensione graduale ad altre categorie, con revisione delle regole di riassortimento e dell’open-to-buy (OTB) alla luce dei risultati del pilot.
- Run time operations: il modello entra nella routine quotidiana di planning, con un ciclo stabile di revisione delle eccezioni.
I tempi tipici: un pilot in shadow mode richiede in genere sei o otto settimane per produrre risultati misurabili, mentre il passaggio a scala completa può richiedere diversi mesi, soprattutto perché servono governance e risorse dedicate a gestire le eccezioni che il modello da solo non risolve.
I KPI di successo da fissare prima di iniziare:
- Riduzione della forecast accuracy error sui SKU pilota rispetto al metodo precedente.
- Riduzione del tasso di markdown a fine stagione sulle categorie coinvolte.
- Tempo medio di reazione a un segnale di sensing (quanto passa tra segnale e azione di riassortimento).
Sul processo decisionale quotidiano, definisci prima di partire chi ha l’autorità di modificare una previsione automatica: un planner senior, non l’algoritmo, deve poter rilasciare un’eccezione motivata quando ha informazioni che il modello non possiede, come un accordo commerciale non ancora inserito a sistema. Le decisioni sull’assortimento e sugli ordini minimi per fornitore restano collegate a questo processo, e vale la pena consultare una guida su MOQ wholesale e ordini per stile per capire come integrare i vincoli di fornitura nel ciclo di pianificazione.
Che infrastruttura dati serve per un forecasting avanzato
Nessun modello, per quanto sofisticato, compensa dati sporchi o frammentati. La priorità assoluta è normalizzare le fonti prima di introdurre qualsiasi algoritmo predittivo.
Le fonti da collegare in ordine di priorità sono le vendite POS giornaliere per punto vendita e per SKU, i dati e-commerce con timestamp coerenti, i movimenti di magazzino e i dati promozionali storicizzati con le date esatte di inizio e fine. Ogni fonte deve condividere lo stesso identificatore prodotto: se il codice SKU cambia formato tra negozio fisico ed e-commerce, qualsiasi previsione a valle parte già compromessa.
Sul lato tecnologico, i sistemi ERP come SAP S/4HANA gestiscono la parte transazionale e anagrafica, ma raramente bastano da soli per il forecasting avanzato. Servono connettori di integrazione (come Boomi) che portano i dati POS ed e-commerce verso una piattaforma dati centralizzata, e strumenti come Databricks o Snowflake per storicizzare volumi elevati di dati granulari e renderli disponibili ai modelli statistici e di machine learning senza duplicazioni.
Tre requisiti di qualità dato non sono negoziabili:
- Storico per SKU di almeno due o tre stagioni, pulito da rotture di continuità come cambi di codifica prodotto.
- Identificatori unici coerenti tra tutti i canali di vendita.
- Log delle promozioni e degli eventi commerciali, perché senza questo contesto un picco di vendita viene letto come domanda organica e distorce il modello per le stagioni successive.
Un ultimo punto spesso sottovalutato è l’explainability: quando un ensemble ibrido combina più modelli, il planner deve poter vedere quale componente ha pesato di più su una specifica previsione, altrimenti la fiducia nel sistema crolla alla prima previsione sbagliata. Le reconciliation tra modelli diversi, quando divergono, vanno documentate e revisionate, non nascoste sotto una media aggregata.
Come GreenSharp supporta i progetti di previsione domanda nel fashion
GreenSharp lavora sul lato infrastrutturale e architetturale dei progetti di forecasting per brand moda e retail, con un focus su integrazione dati, implementazione di SAP S/4HANA e costruzione di architetture capaci di alimentare modelli statistici e di demand sensing con dati puliti e continui.
In un progetto pilota tipico, le attività concrete comprendono:
- Audit dello stato attuale dei dati POS, e-commerce e di magazzino, con identificazione delle lacune che bloccherebbero il sensing.
- Connessione dei feed di vendita giornalieri tramite connettori di integrazione, evitando duplicazioni tra sistemi.
- Costruzione di dashboard KPI condivise tra planning, merchandising e IT, per tenere accuratezza e sell-through sotto controllo in tempo reale.
- Formazione dei planner sull’interpretazione dei nuovi output previsionali, passaggio spesso più critico della tecnologia stessa.
L’autrice di questo approfondimento, Silvia, contribuisce ai contenuti tecnici di GreenSharp sui temi di trasformazione digitale e architetture dati applicate al retail e al lusso, con particolare attenzione a come i sistemi IT tradizionali si integrano con strumenti previsionali più avanzati.
Dati, algoritmi e la parte che nessun modello prevede
Nessun modello statistico, per quanto raffinato, sa che il buyer ha appena visto una collezione della concorrenza andare esaurita in tre giorni. L’automazione riduce l’errore sistematico, ma non elimina il bisogno di un giudizio umano informato su ciò che i dati storici non possono contenere: una tendenza nuova, un cambio di gusto improvviso, una scelta creativa che rompe volutamente con lo storico venduto.
Il dialogo tra planner e team design dovrebbe diventare una pratica regolare, non un’eccezione gestita in emergenza. E l’unico modo per capire cosa funziona davvero nel proprio assortimento è iterare con una governance chiara su chi decide cosa, invece di aspettare il modello perfetto prima di iniziare.
— Silvia
Avvia un progetto pilota di demand sensing con GreenSharp
Ci sono guide, white paper e strumenti generici che spiegano cosa sia il demand sensing, ma pochi aiutano un brand moda a passare dalla teoria a un pilot funzionante in poche settimane. GreenSharp costruisce l’architettura dati e l’integrazione tecnica che rendono possibile quel passaggio, lavorando fianco a fianco con i team di planning e IT invece di limitarsi a consegnare un report.
Un percorso pilota con GreenSharp comprende tipicamente un audit dello stato dei dati esistenti, l’integrazione dei feed POS ed e-commerce, e una fase di proof-of-value per misurare il reale impatto sull’accuratezza prima di estendere il progetto ad altre categorie. Il beneficio commerciale atteso è concreto: meno invenduto sui capi ad alta rotazione e decisioni di riassortimento più rapide, basate su segnali reali invece che su intuizioni corrette a posteriori.
Se gestisci previsione e assortimento per un brand moda o retail e vuoi capire come allineare IT e strategia su questo tema, la pagina Business Technology Architects descrive come GreenSharp struttura questi progetti dall’audit iniziale alla messa a scala. Puoi anche approfondire il nostro processo di consulenza per capire tempi e modalità di avvio di un primo pilot.
Fonti
- I consumi di moda in Italia verso la ripresa nel biennio 2026-27 – FashionNetwork Italia
- How to Implement Demand Sensing: AI Forecasting Use Case | Impact Analytics
- What is Demand Sensing and How Does it Work? | Infor
Domande frequenti
Quali sono le previsioni per il settore della moda?
Il settore mostra segnali di ripresa contenuta per il biennio 2026-27 in Italia, con prezzo e Made in Italy come driver principali delle scelte d’acquisto, più che la crescita dei volumi.
Qual è l’andamento del settore moda nel 2026?
L’andamento resta improntato alla cautela: la crescita è contenuta e i consumatori restano molto sensibili al prezzo, il che rende la previsione della domanda e il controllo del margine ancora più decisivi rispetto a fasi di espansione più solida.
Demand sensing e previsione tradizionale sono la stessa cosa?
No. La previsione tradizionale stima la domanda su un orizzonte lungo usando dati storici, mentre il demand sensing corregge quella stima nel breve periodo usando segnali live come vendite giornaliere e traffico online.
Quanti dati storici servono per una previsione affidabile?
Servono almeno due o tre stagioni di storico per SKU, pulito da interruzioni come cambi di codifica prodotto: senza questa base, anche i modelli più avanzati restituiscono risultati poco affidabili.
Come si riduce concretamente l’errore di previsione sulla moda?
Combinando una baseline statistica stabile con un layer di demand sensing su dati POS giornalieri, e definendo regole chiare di riassortimento e open-to-buy per gestire le eccezioni caso per caso.
Raccomandati
- MOQ wholesale moda: quanto ordinare per stile e per fornitore
- SAP S/4HANA for Fashion: la guida per i brand moda
- CallOff Optimizer
