Se il sistema di partenza è ECC e l’obiettivo è S/4HANA, la scelta tra conversione e nuova implementazione dipende dalla qualità dei dati esistenti e dal livello di personalizzazione accumulato. Nella maggior parte dei casi con dati puliti conviene la conversione (brownfield); con debito tecnico elevato, il greenfield. In entrambi i casi, la prima settimana va dedicata a Readiness Check, inventario dati e backup completo, mentre Migration Cockpit, SUM e SDMI restano gli strumenti da preparare per le fasi successive.
In breve:
- La scelta tra greenfield e brownfield dipende dalla qualità dei dati e dall’entità delle personalizzazioni, con il greenfield più indicato per sistemi obsoleti o altamente personalizzati.
- Prima di tutto, è fondamentale eseguire un Readiness Check e un Simplification Item Check aggiornati e completi, applicando gli ultimi Support Package prima di iniziare.
- Per grandi volumi di dati, l’uso di strumenti ETL come SAP Data Services abbinati a Remote HANA schema è più scalabile rispetto ai template manuali.
- La gestione efficace della qualità dei dati richiede profilazione, deduplicazione e test di riconciliazione accurati, verificando che i dati siano corretti prima del caricamento finale.
- La migrazione delle interfacce PI/PO verso SAP Cloud Integration richiede attenzione ai gap di compatibilità e spesso necessita di riscrittura e riconfigurazione manuale per una transizione senza problemi.
Indice
- Quali sono le opzioni per la migrazione dati S/4HANA?
- Come funzionano i pre-check tecnici prima della conversione?
- Quali strumenti si usano per la migrazione dati S/4HANA?
- Come si gestisce la qualità dei dati durante la migrazione?
- Come si migrano le interfacce PI/PO verso Integration Suite?
- Come si esegue il cutover: ondate, test paralleli e SDMI
- Chi deve occuparsi della governance e del cambiamento
- In che modo Greensharp supporta la migrazione dati S/4HANA
- Quali sono i prossimi passi da seguire subito
- Cosa conta davvero in un progetto di migrazione dati
- Come Greensharp accompagna la migrazione dati verso S/4HANA
- Documentazione e risorse ufficiali per approfondire
- Fonti
Quali sono le opzioni per la migrazione dati S/4HANA?
La scelta tra greenfield, brownfield e hybrid determina tempi, costi e rischio del progetto più di qualsiasi altro fattore tecnico. Non è una decisione stilistica: cambia radicalmente cosa succede ai dati, ai processi custom e alle interfacce esistenti.
Greenfield significa ripartire da zero: nuova implementazione, processi ridisegnati secondo i modelli standard SAP, dati migrati selettivamente. È l’opzione giusta quando il sistema ECC ha accumulato personalizzazioni obsolete, processi mai riallineati al business reale, o quando l’azienda vuole comunque ripensare l’organizzazione dei dati. Il costo è più alto e i tempi si allungano, ma il risultato è un sistema pulito, senza eredità di scelte fatte quindici anni prima da un altro team.
Brownfield è la conversione tecnica del sistema esistente: stessa configurazione, stessi dati, stesso codice custom, ma su nuovo database e nuovo modello dati S/4HANA. È più rapido e più economico, ma porta con sé ogni compromesso tecnico accumulato negli anni. Se il sistema ECC è in buone condizioni, con codice custom limitato e ben documentato, il brownfield è quasi sempre la scelta più razionale.
Hybrid (spesso chiamato anche selective data transition) sta nel mezzo: si convertono processi e configurazioni core, ma si ridisegnano selettivamente aree specifiche, magari un singolo modulo finanziario o una linea di business che necessita di ristrutturazione profonda. Richiede più competenza di pianificazione perché mescola due logiche di migrazione all’interno dello stesso progetto.
I criteri pratici per decidere non sono astratti:
- Livello di personalizzazione: sopra una certa soglia di codice Z, la conversione diventa più complessa del previsto, perché ogni riga custom va validata contro il nuovo modello dati.
- Qualità dei dati storici: anagrafiche duplicate, materiali obsoleti e master finanziari incoerenti pesano meno in un greenfield (si migra solo ciò che serve) e pesano moltissimo in un brownfield.
- Obiettivi di standardizzazione: se l’azienda vuole allinearsi ai processi SAP standard per ridurre il costo di manutenzione futura, il greenfield accelera quell’obiettivo; la conversione lo rimanda.
- Tempistiche di business: un brownfield ben pianificato può chiudersi in mesi, non anni; un greenfield su un’organizzazione complessa richiede cicli di workshop, disegno processi e test molto più lunghi.
Una guida strategica sulla scelta tra brownfield e greenfield sottolinea un punto spesso sottovalutato: la decisione tecnica va sempre validata con il change management, perché la resistenza degli utenti chiave a un cambio radicale di interfaccia può vanificare i risparmi ottenuti scegliendo l’opzione più rapida.
Come funzionano i pre-check tecnici prima della conversione?
Prima di toccare un solo record di dati, il sistema sorgente va sottoposto a una serie di verifiche che stabiliscono cosa è compatibile, cosa richiede intervento e cosa blocca del tutto il progetto.
Il Readiness Check analizza il sistema ECC e produce un report che copre volumi dati, utilizzo add-on, dipendenze e stima delle attività di conversione. Va letto insieme al Simplification Item Check (SI-Check), che identifica quali “simplification items” (le aree dove S/4HANA cambia struttura dati o logica rispetto a ECC, come la gestione del Business Partner) impattano il sistema specifico. La Conversion Guide ufficiale per SAP S/4HANA 2025 descrive nel dettaglio come questi due strumenti, insieme alla Custom Code Analysis, formino il primo blocco di attività da eseguire prima di qualsiasi decisione di progetto.
La sequenza operativa da seguire è questa:
- Eseguire il Readiness Check sul sistema di produzione (o una copia recente) per ottenere il quadro complessivo di volumi e complessità.
- Analizzare l’output del SI-Check per mappare ogni simplification item rilevante alle aree funzionali coinvolte, assegnando un owner per ciascuna.
- Lanciare la Custom Code Migration per individuare gli adattamenti richiesti nel codice Z, prioritizzando quello effettivamente ancora in uso.
- Usare il Maintenance Planner per generare lo stack file necessario a preparare il Software Update Manager (SUM), verificando compatibilità delle add-on e dei componenti installati.
- Pianificare backup completi e test di restore prima di qualsiasi attività distruttiva sul sistema sorgente.
Un consiglio: non fidatevi di un Readiness Check eseguito su un ambiente non aggiornato: se il sistema sorgente ha patch di sicurezza o note SAP mancanti da mesi, il report può sottostimare le criticità reali. Rilanciatelo dopo aver applicato gli ultimi Support Package.
Sul fronte backup, la prassi solida prevede almeno uno snapshot completo del database prima dell’avvio del Maintenance Planner, un test di restore verificato (non solo eseguito) su un ambiente isolato, e una copia aggiuntiva subito prima del cutover finale. Saltare il test di restore è l’errore più comune: un backup che non si è mai verificato di poter ripristinare non è un backup, è una scommessa.
Quali strumenti si usano per la migrazione dati S/4HANA?
Il cuore tecnico del progetto è la scelta del metodo di trasferimento dati, e qui le opzioni non sono equivalenti: cambiano in base a volume, complessità del mapping e vincoli infrastrutturali.
Il SAP S/4HANA Migration Cockpit è lo strumento standard incluso nel sistema, senza costi aggiuntivi separati, e mette a disposizione una libreria di migration object templates predefiniti per gli scenari più comuni: anagrafiche cliente, materiali, ordini aperti, dati finanziari. Attraverso l’app Migrate Your Data, il Cockpit supporta tre metodi distinti:
- Local staging tables: le tabelle di staging vengono create direttamente nel database S/4HANA; l’utente compila i template XML o CSV scaricati dal sistema e li ricarica. È il metodo più semplice, adatto a volumi contenuti.
- Remote HANA schema: le staging table risiedono in uno schema HANA remoto, accessibile da strumenti ETL esterni per popolare i dati in modo massivo e automatizzato.
- RFC direct transfer: il trasferimento avviene tramite connessione RFC diretta da un sistema sorgente SAP, utile quando si migra da un altro ambiente SAP già strutturato in modo simile.
Il Migration Cockpit supporta esattamente questi tre metodi, e la scelta tra loro non è indifferente: i template manuali funzionano bene su poche migliaia di record, ma diventano ingestibili quando si parla di milioni di righe di ordini storici o anagrafiche materiali complesse.
Il punto che molti progetti sottovalutano: per volumi elevati, popolare le staging table via Remote HANA schema con strumenti ETL come SAP Data Services o SAP Data Intelligence (SDI) è più efficiente e scalabile del caricamento manuale tramite template. Un approfondimento tecnico della community SAP sul Migration Cockpit descrive proprio come questa combinazione riduca drasticamente i tempi di caricamento rispetto all’importazione file per file, soprattutto quando i dati richiedono trasformazioni complesse durante il transito.
La regola pratica che vale la pena adottare presto nel progetto: i file template vanno bene per dataset piccoli e stabili, mentre il Remote HANA schema abbinato a un motore ETL è preferibile appena i volumi superano la soglia gestibile manualmente, tipicamente quando servono cicli di caricamento ripetuti con logiche di trasformazione non triviali.
Vale la pena considerare anche strumenti ETL di terze parti quando l’azienda ha già investito in una piattaforma di integrazione dati aziendale: in quel caso, replicare la logica di trasformazione già esistente può costare meno che ricostruirla da zero dentro SAP Data Services.
Come si gestisce la qualità dei dati durante la migrazione?
I dati sporchi non emergono durante la migrazione: emergono dopo, quando un report finanziario non chiude o un cliente riceve due fatture duplicate. La sequenza corretta previene questo scenario invece di scoprirlo in produzione.
Il processo segue cinque fasi in ordine stretto:
- Profilazione: si analizza il dataset sorgente per individuare pattern anomali, valori nulli, formati inconsistenti e duplicati potenziali, prima ancora di decidere le regole di trasformazione.
- Regole di pulizia: sulla base della profilazione si definiscono le regole di standardizzazione, ad esempio normalizzare formati di indirizzo o codici fiscali.
- Matching e deduplicazione: si identificano record che rappresentano la stessa entità sotto chiavi diverse, decidendo criteri di merge e un record “master” per ciascun gruppo.
- Mapping: si definisce come ogni campo sorgente si traduce nel modello dati target, incluse le conversioni di codici e le tabelle di corrispondenza.
- Test di riconciliazione: si confrontano totali, conteggi record e checksum tra sorgente e target per certificare che nulla sia andato perso o duplicato nel transito.
Per il Business Partner, che in S/4HANA unifica i concetti di cliente e fornitore prima separati in ECC, la regola di mapping più delicata riguarda la gestione dei ruoli: un’anagrafica che in ECC esisteva solo come cliente deve ricevere il ruolo BP corretto senza generare duplicati con fornitori collegati alla stessa entità legale. Sulle anagrafiche materiali, il problema tipico è la coesistenza di più codici per lo stesso articolo, spesso creati da filiali diverse: la deduplicazione richiede regole di matching su descrizione, unità di misura e categoria merceologica, non solo sul codice. Sui master finanziari, il rischio maggiore è la mancata riconciliazione tra piano dei conti sorgente e nuova struttura contabile, che se non testata a fondo produce sbilanci silenziosi visibili solo mesi dopo.
Un consiglio: fate girare i test di riconciliazione su un sottoinsieme di dati reali, non solo su dati di test sintetici. I casi limite (un cliente con partita IVA mancante, un materiale con unità di misura non standard) emergono quasi sempre solo con dati di produzione veri.
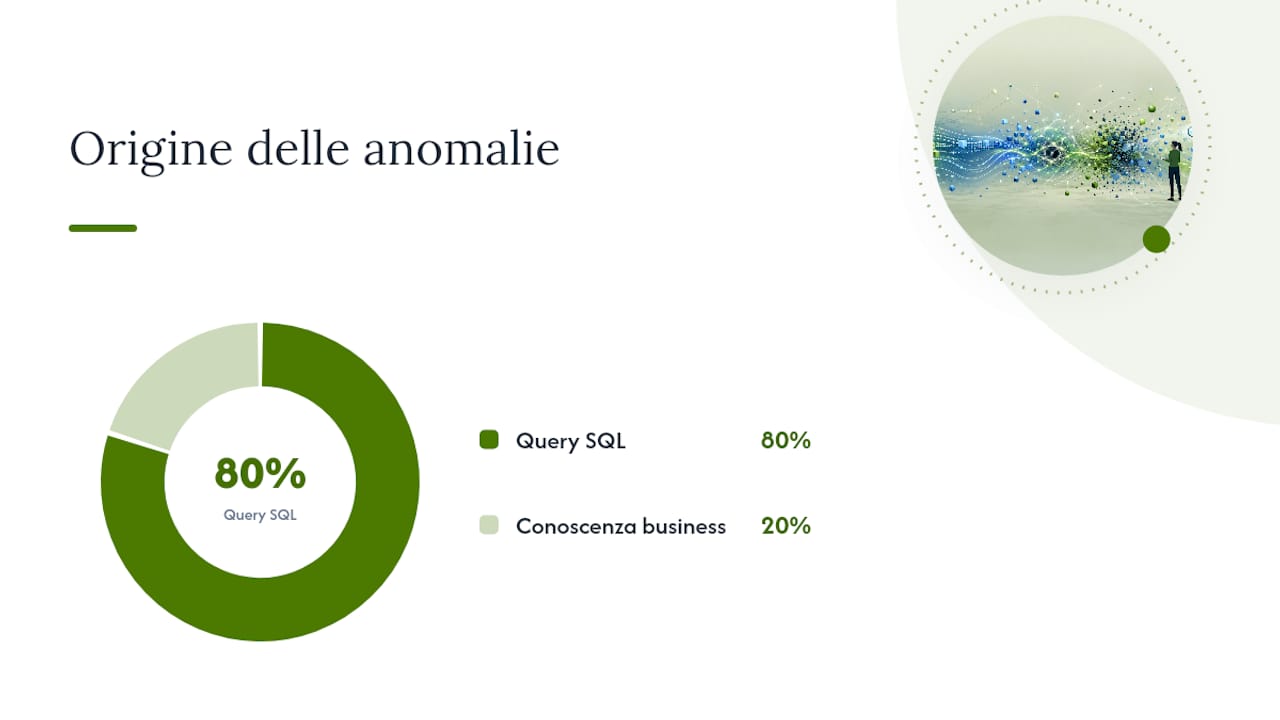
Gli strumenti di data profiling non devono essere necessariamente sofisticati: spesso bastano query SQL mirate sul database sorgente per individuare l’80% delle anomalie. Il resto richiede la conoscenza del business, cosa che nessun tool automatizza davvero.
Come si migrano le interfacce PI/PO verso Integration Suite?
Le interfacce sono la parte del progetto che i piani iniziali sottostimano quasi sempre, perché sembrano un problema tecnico contenuto e invece nascondono dipendenze nascoste con anni di configurazione.
Il primo passo è l’assessment: SAP classifica ogni artefatto PI/PO in categorie come “Ready to Migrate” o “Evaluation Required” in base alla compatibilità con Integration Suite. Ma questa etichetta va letta con cautela. Una guida completa alla migrazione da PI/PO a Cloud Integration chiarisce che “Ready to Migrate” non equivale a production ready: restano quasi sempre gap tecnici da risolvere manualmente prima di andare live.
I gap più frequenti riguardano tre aree:
- Java mappings: mapping scritti in Java puro raramente si convertono in modo automatico e spesso richiedono riscrittura nel nuovo modello di integrazione.
- Value mappings: le tabelle di corrispondenza valori configurate in PI/PO non vengono trasferite automaticamente e devono essere ricostruite in Integration Suite.
- Credential management: le credenziali di connessione ai sistemi esterni non si migrano per motivi di sicurezza e vanno riconfigurate manualmente per ogni interfaccia.
La parte interessante è che questi gap, per quanto fastidiosi, sono anche i più automatizzabili. Automatizzare la creazione delle credenziali e degli script di value mapping tramite le API di Cloud Integration può far risparmiare giorni di lavoro manuale su landscape con decine di interfacce, invece di ricostruire ogni oggetto a mano uno per uno.
Sul piano architetturale, il consiglio che vale per la maggior parte dei progetti è non limitarsi a replicare la topologia PI/PO esistente dentro Integration Suite. Due pattern aiutano a ottenere un’architettura più resiliente: un event broker centralizzato per decouplare sistemi produttori e consumatori di eventi, ed un approccio API-first dove ogni nuova integrazione viene progettata come API riutilizzabile piuttosto che come flusso punto a punto. Chi migra “com’è” spesso si ritrova a rifare lo stesso lavoro di razionalizzazione un paio d’anni dopo.
Come si esegue il cutover: ondate, test paralleli e SDMI
L’esecuzione è dove la pianificazione incontra la realtà, e la sequenza con cui si migrano gli oggetti dati determina quanto sarà doloroso il weekend di cutover.
Le anagrafiche (materiali, clienti, fornitori, Business Partner) vanno sempre nella prima ondata, perché tutto il resto dipende da loro. Le transazioni aperte (ordini, fatture non saldate) seguono in una seconda ondata, con particolare attenzione ai documenti che attraversano il periodo di transizione. I dati storici e archiviati, quando previsti, arrivano per ultimi, spesso con un approccio incrementale che non blocca il go live.
Il piano operativo tipico segue questi passi:
- Definire i wave in base alle dipendenze tra oggetti, non alla loro complessità tecnica.
- Eseguire un ciclo completo di migrazione in ambiente sandbox per validare mapping e volumi.
- Ripetere il ciclo in ambiente di pre-produzione con dati realistici, misurando tempi effettivi di caricamento.
- Lanciare test paralleli tra sistema sorgente e target, confrontando output di processi chiave (chiusura contabile, evasione ordini) sugli stessi dati.
- Congelare le modifiche al sistema sorgente nella finestra pre cutover e monitorare il Data Migration Status durante il caricamento finale.
I test paralleli sono il momento in cui emergono gli edge case che nessuna checklist prevede: un cliente con indirizzo di fatturazione in un paese non gestito dal nuovo mapping, un ordine con quantità frazionaria che il nuovo modello dati rifiuta. Eseguire almeno due cicli completi di test, uno in sandbox e uno in pre-produzione con confronto diretto degli output, resta la prassi più solida per intercettarli prima del go live.
Sulla scelta tra downtime classico e Silent Data Migration Infrastructure (SDMI), la Conversion Guide di SAP chiarisce che SDMI permette di spostare parte della migrazione dati fuori dalla finestra di downtime per le release supportate, riducendo l’interruzione percepita dagli utenti. Ma è un’opzione condizionata: richiede compatibilità di release specifica e va valutata contro i vincoli dello stack tecnico già in uso, non applicata come regola generale.
| Scenario | Approccio consigliato | Vincolo principale |
|---|---|---|
| Volumi dati contenuti, downtime accettabile | SUM con DMO classico | Finestra di downtime pianificata |
| Release compatibile, downtime critico per il business | SDMI | Compatibilità di release da verificare in anticipo |
| Landscape complesso con più sistemi satellite | Wave plan con test paralleli estesi | Coordinamento tra team funzionali e tecnici |
Chi deve occuparsi della governance e del cambiamento
La tecnologia sposta i dati. Le persone decidono se il nuovo sistema funziona davvero. Sono due problemi diversi, e trattarli come uno solo è il motivo per cui molti progetti tecnicamente riusciti falliscono nell’adozione.
I ruoli essenziali da assegnare fin dall’inizio sono chiari:
- Data owner funzionale: una persona per ciascun dominio dati (finanza, vendite, materiali) responsabile della qualità e delle decisioni di mapping in quell’area.
- Migration lead tecnico: coordina strumenti, wave plan e test, riportando direttamente sullo stato di avanzamento.
- Key user per area di processo: valida che i dati migrati supportino davvero i processi quotidiani, non solo che siano “tecnicamente corretti”.
- Sponsor di progetto: sblocca le decisioni di business quando emergono conflitti tra velocità e qualità.
Sul fronte comunicazione, la sequenza che funziona meglio prevede sessioni informative ai key user molto prima del cutover, non a ridosso di esso, seguite da formazione pratica sui nuovi processi (non solo sulla nuova interfaccia) e un canale di supporto dedicato aperto nelle prime settimane post go live. L’esperienza condivisa dalla community SAP conferma che sottovalutare la formazione e il coinvolgimento degli utenti chiave resta uno dei fattori più ricorrenti dietro un’adozione fallita, anche quando la migrazione tecnica è andata perfettamente.
I KPI da monitorare durante e dopo il progetto non dovrebbero limitarsi a “record migrati con successo”. Vale la pena tracciare anche il tempo medio di risoluzione dei ticket di supporto nelle prime settimane, il numero di transazioni riproposte manualmente per errori di dati, e il tasso di adozione delle nuove funzionalità rispetto ai vecchi workaround. Sono questi numeri, non il conteggio dei record, a dire se la migrazione ha davvero funzionato.
Un consiglio: nominate il data owner funzionale prima ancora di scegliere lo strumento di migrazione. Un buon owner con visibilità sui dati reali vale più di qualsiasi tool sofisticato scelto senza qualcuno che ne conosca a fondo il contenuto.
In che modo Greensharp supporta la migrazione dati S/4HANA
Le imprese del lusso e del retail che si affidano a Greensharp per progetti su SAP S/4HANA affrontano tipicamente landscape complessi: più country, integrazioni con piattaforme di e-commerce, sistemi POS e flussi wholesale che non tollerano interruzioni prolungate. In questi contesti la sequenza descritta finora, dal Readiness Check fino al wave plan di cutover, non è teoria da manuale ma il percorso concreto seguito progetto per progetto.
L’approccio operativo di Greensharp segue una logica coerente con quanto illustrato in questo articolo:
- Assessment iniziale del sistema sorgente, con lettura congiunta di Readiness Check e Simplification Item Check per definire lo scenario più adatto (conversione, nuova implementazione o approccio selettivo).
- Pianificazione dei wave di migrazione dati calibrata sulle dipendenze reali tra anagrafiche, transazioni e interfacce, non su un template generico.
- Gestione delle integrazioni critiche, incluse le migrazioni da PI/PO verso Integration Suite, con attenzione specifica ai gap di credenziali e value mapping che emergono quasi sempre in questa fase.
- Supporto alla formazione dei key user e al processo di gestione del cambiamento necessario per un’adozione solida oltre il go live.
Un percorso di lavoro tipico parte da un assessment tecnico documentato, prosegue con un piano di migrazione condiviso con i data owner interni, e si chiude con un ciclo di test paralleli e formazione mirata prima del cutover finale. Chi gestisce un progetto simile e vuole confrontare il proprio piano con l’esperienza maturata su casi analoghi nel lusso e nel retail può approfondire i servizi di consulenza SAP ERP offerti da Greensharp.
Quali sono i prossimi passi da seguire subito
La sequenza operativa che segue non è teorica: è l’ordine in cui le attività vanno effettivamente avviate per non perdere tempo nelle prime settimane critiche.
- Settimana 1: eseguire Readiness Check e Simplification Item Check sul sistema sorgente, avviare l’inventario dati per dominio e pianificare il primo backup completo con test di restore.
- Settimane 2 e 3: analizzare gli output dei pre-check, assegnare i data owner funzionali e decidere lo scenario di migrazione (greenfield, brownfield o hybrid) sulla base di personalizzazioni e qualità dati reali.
- Settimane 4 e 6: avviare la profilazione dati e definire le regole di deduplicazione e mapping per i dataset principali, in parallelo con l’assessment delle interfacce PI/PO.
- Mesi 2 e 3: costruire il wave plan, eseguire il primo ciclo di migrazione in sandbox e avviare i test paralleli sui processi chiave.
- Mese 3 in avanti: ripetere i test in pre-produzione, definire la strategia di cutover (downtime classico o SDMI dove compatibile) e pianificare formazione e supporto post go live.
Queste sono stime indicative: un landscape con più country o interfacce numerose allunga naturalmente ogni fase. Il segnale più chiaro per richiedere supporto esterno arriva quando l’assessment iniziale rivela più simplification item critici del previsto, o quando il team interno non ha mai gestito un ciclo di test paralleli su questa scala: in quel momento, un partner con esperienza specifica riduce il rischio più di qualsiasi checklist aggiuntiva.
Cosa conta davvero in un progetto di migrazione dati
La parte tecnica della migrazione dati verso S/4HANA è, paradossalmente, la più facile da controllare: strumenti come il Migration Cockpit e SUM sono documentati, testati da migliaia di progetti e abbastanza prevedibili nel comportamento. Quello che fa deragliare i progetti quasi sempre non è lì.
È nella zona grigia tra “tecnicamente migrato” e “pronto per la produzione” che si concentra il rischio reale, in particolare sulle interfacce. Un artefatto PI/PO classificato come pronto dall’assessment automatico può ancora richiedere settimane di lavoro manuale su credenziali e value mapping, e i piani di progetto che non riservano tempo esplicito a questa fase finiscono quasi sempre per sfondare le scadenze.
L’altro punto sottovalutato è la governance dei dati come attività, non come documento. Nominare un data owner su carta non basta: serve qualcuno che conosca davvero il contenuto delle anagrafiche prima che diventi un problema in produzione. Le aziende che investono tempo qui, prima ancora di scegliere lo strumento ETL, arrivano al cutover con meno sorprese.
Il consiglio pratico è semplice: trattate i test paralleli come parte del budget di progetto, non come un’attività opzionale da comprimere se i tempi stringono. È lì che si scoprono gli edge case, non nella demo dello strumento.
— Silvia
Come Greensharp accompagna la migrazione dati verso S/4HANA
Il partner tecnico ideale per aziende del lusso e del retail affronta la migrazione dati come parte di un progetto più ampio di trasformazione su SAP S/4HANA, SAP BTP e piattaforme di integrazione come Boomi. La differenza concreta rispetto a un progetto gestito solo con risorse interne consiste nella combinazione di competenze tecniche su Migration Cockpit, SUM e integrazioni PI/PO, unite all’esperienza sui processi di settore, dalla gestione ordini wholesale alla customer experience omnicanale.
Il percorso operativo tipico include un assessment tecnico del sistema sorgente, la definizione del wave plan, l’esecuzione dei test paralleli, e si conclude con la formazione dei key user e il supporto nelle settimane successive al go live. Ogni fase produce output verificabili come report di readiness, piano di migrazione condiviso ed esiti dei test di riconciliazione, per garantire trasparenza sullo stato delle attività.
Chi vuole allineare la strategia IT alla roadmap di business prima di avviare il progetto può approfondire l’approccio dei business technology architects di Greensharp, pensato proprio per collegare le decisioni tecniche di migrazione agli obiettivi aziendali reali. Il passo successivo naturale è richiedere una valutazione tecnica del proprio sistema sorgente per definire lo scenario di migrazione più adatto e i tempi realistici del progetto.
Documentazione e risorse ufficiali per approfondire
Ogni fase del progetto ha una fonte di riferimento diversa, ed è utile sapere a quale rivolgersi quando serve verificare un dettaglio tecnico specifico.
- Per i pre-check e la pianificazione della conversione, la Conversion Guide ufficiale per SAP S/4HANA 2025 resta il riferimento più completo su Maintenance Planner, SUM e SDMI.
- Per il funzionamento del Migration Cockpit e i metodi di trasferimento dati, la documentazione SAP Learning e i blog tecnici della community SAP offrono esempi pratici con screenshot e casi d’uso reali.
- Per la migrazione delle interfacce PI/PO, la guida completa a Cloud Integration descrive nel dettaglio i gap tipici dell’assessment automatico.
- Per un quadro sulla diffusione della piattaforma, i dati Statista su S/4HANA offrono contesto sulla crescita continua del numero di clienti nel tempo.
Fonti
Raccomandati
- ERP SAP S/4HANA: Guida alla Trasformazione Digitale
- Pulizia dati pre go live: la checklist che evita il caos ERP
- Visibilità ordini: integrare CRM con SAP in 6 fasi per IT e decisori
- Integrazione e-commerce SAP: guida tecnica per professionisti IT
